Googleは、Google Cloudの一部として、使用量ベースのコスト構造を備えたGoogle TranslationAPIを提供しています。 キーなしで使用できるが、ほんの数回の要求の後で機能することを拒否する、文書化されていないAPIもあります。 Google Chromeのウェブサイト翻訳機能を使用すると、目立った制限なしにページを非常に高品質に翻訳できることがわかります。
どうやらここでは高度なnmtモデルがすでに使用されているようです。しかし、Google Chrome はコンテンツを翻訳するために内部でどの API を使用するのでしょうか? また、サーバー側であっても、この API に直接アクセスすることはできますか?ネットワーク トラフィックを分析するには、暗号化されたトラフィックも分析できるWiresharkやTelerik Fiddlerなどのツールをお勧めします。しかし、Chrome はページを翻訳するときに送信するリクエストも無料で配信します。これらのリクエストはChrome DevTools経由で簡単に表示できます。:
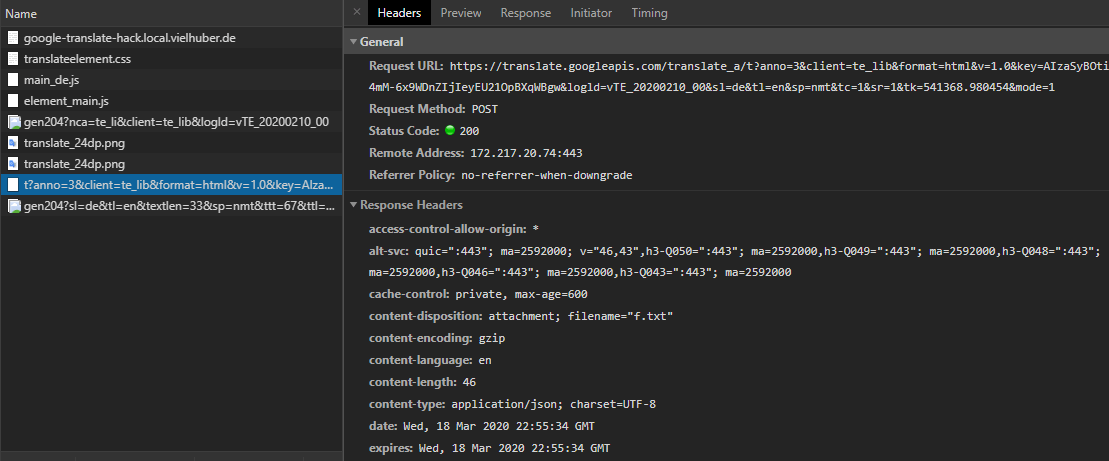
翻訳を実行する場合は、「コピー> cURL(bash)としてコピー」を介してhttps://translate.googleapis.comへの重要なPOSTリクエストをキャッチし、 Postmanなどのツールで実行します。たとえば、問題なくリクエストを再送信できます。:
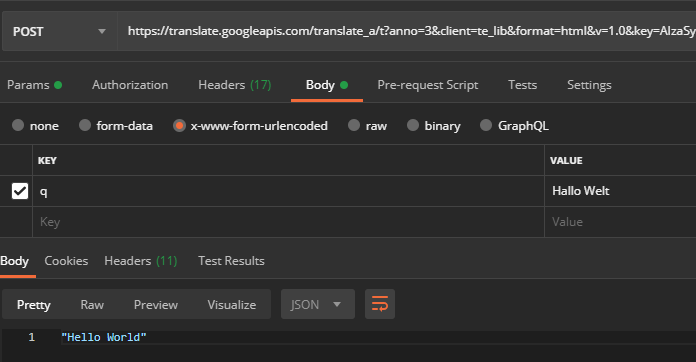
URLパラメータの意味も、ほとんどの場合明らかです。:
| キー | 値の例 | 意味 |
| 安野 | 3 | 注釈モード(戻り形式に影響します) |
| クライアント | te_lib | クライアント情報(値は様々です。Google翻訳のウェブインターフェースでは「webapp」という値になります。返される形式とレート制限に影響します) |
| フォーマット | html | 文字列形式(HTMLタグの翻訳に重要) |
| v | 1.0 | Google翻訳のバージョン番号 |
| キー | AIzaSyBOti4mM-6x9WDnZIjIeyEU21OpBXqWBgw | APIキー(以下を参照) |
| logld | vTE_20200210_00 | プロトコルバージョン |
| sl | de | ソース言語 |
| tl | en | 目標とする言語 |
| sp | nmt | MLモデル |
| tc | 1 | わからない |
| sr | 1 | わからない |
| tk | 709408.812158 | トークン(以下を参照) |
| ファッション | 1 | わからない |
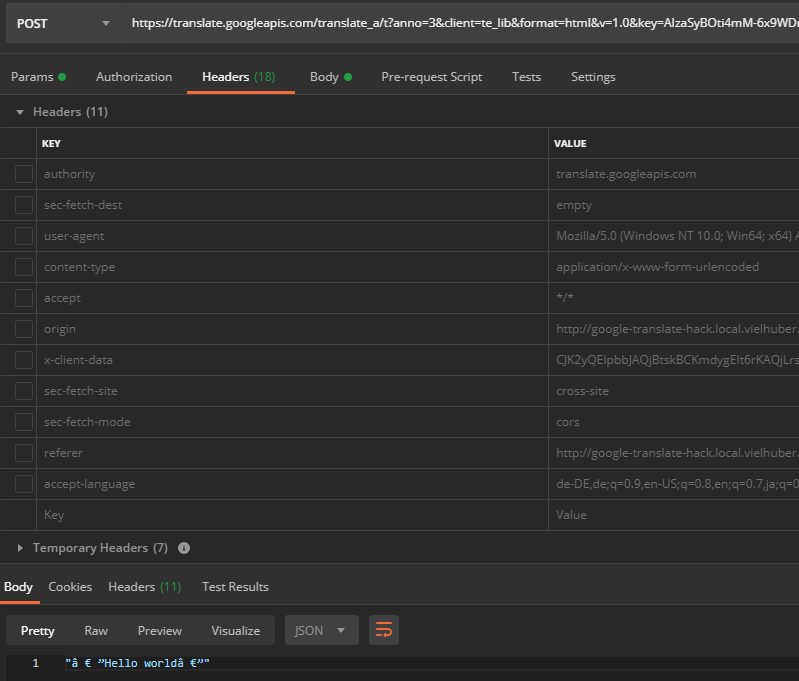
一部のリクエストヘッダーも設定されていますが、これらはほとんど無視できます。 ユーザーエージェントからのヘッダーを含むすべてのヘッダーを手動で選択解除した後、特殊文字を入力するときにエンコードの問題が発見されました(ここでは「 HelloWorld 」を翻訳するとき):
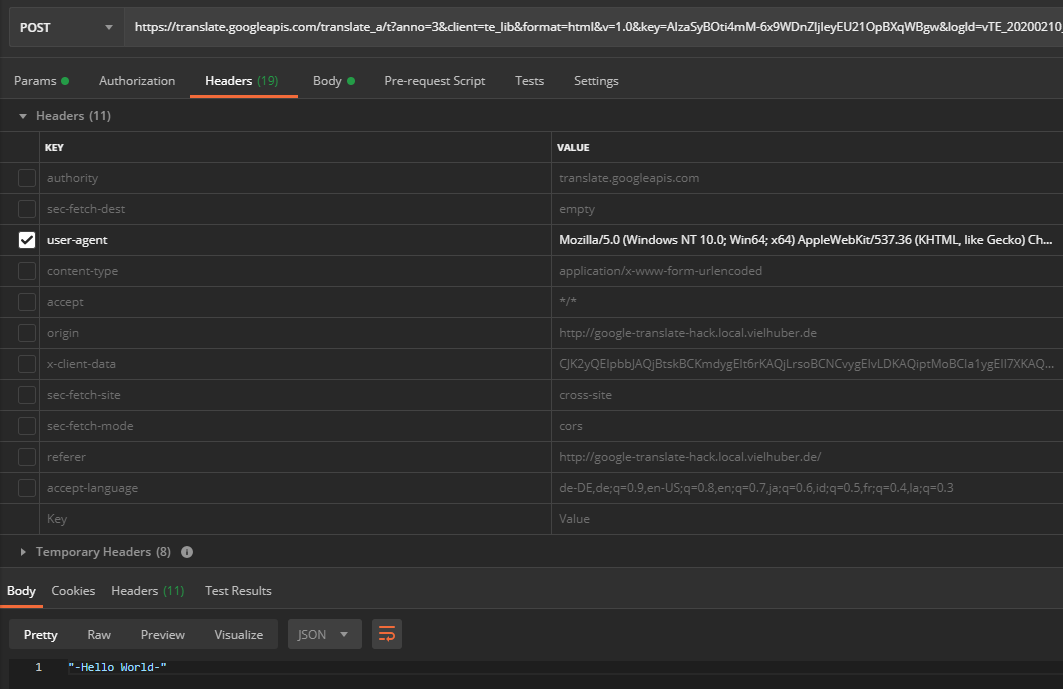
ユーザーエージェントを再アクティブ化すると(通常は害はありません)、APIはUTF-8でエンコードされた文字を配信します:
これで目標を達成し、Google Chrome 以外でこの API を使用するためのすべての情報が揃ったでしょうか?しかし、翻訳する文字列 (POST リクエストのデータ フィールドq ) を、たとえば「Hello World」から「Hello World ! 」に変更すると、エラー メッセージが表示されます。:
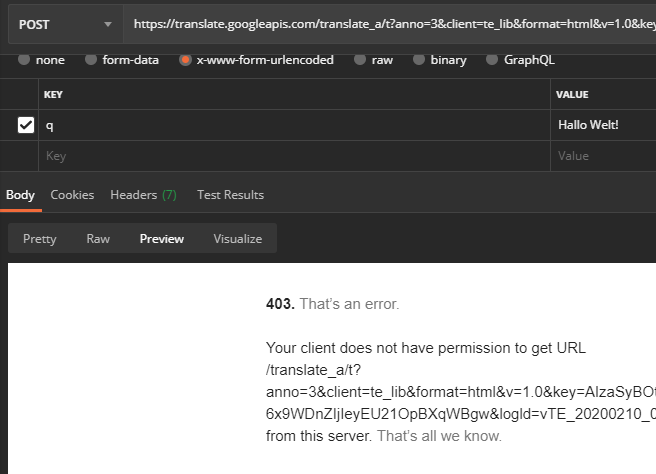
次に、Google Chrome の Web サイト翻訳機能を使用して、この変更された文字列を再度翻訳すると、パラメータqに加えて、パラメータtkも変更されていることがわかります (他のすべてのパラメータは同じままです)。:
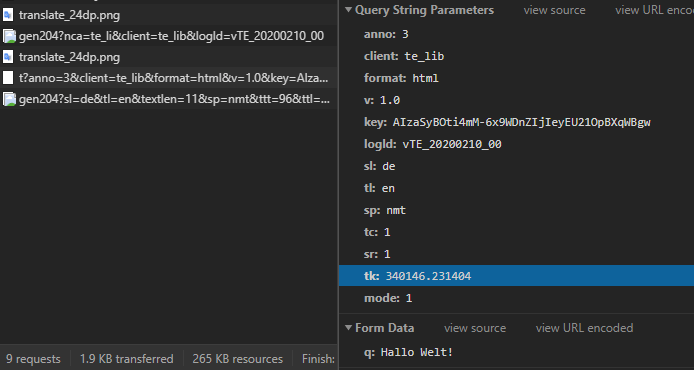
明らかに、それは文字列に依存するトークンであり、その構造は簡単にはわかりません。 ウェブサイトの翻訳を開始すると、次のファイルが読み込まれます:
- 1つのCSSファイル: translateelement.css
- 4つのグラフィック: translate_24dp.png (2x)、 gen204 (2x)
- 2つのJSファイル: main_de.js 、 element_main.js
2つのJavaScriptファイルは難読化され、縮小されています。 JS Niceやde4jsなどのツールは、これらのファイルを読みやすくするのに役立ちます。 それらをライブでデバッグするには、リモートファイルをその場でローカルにトンネリングするChrome ExtensionRequestlyをお勧めします:
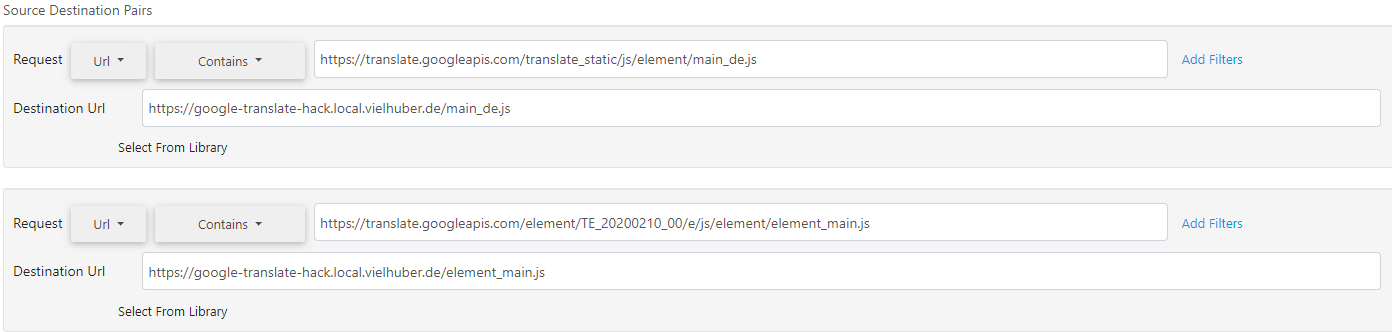
これで、コードをデバッグできます( CORSは最初にローカルサーバーでアクティブ化する必要があります)。 トークンを生成するための関連するコードセクションは、このセクションのelement_main.jsファイルに隠されているようです。:
b7739bf50b2edcf636c43a8f8910def9
ここでは、テキストはいくつかのビットシフトの助けを借りてハッシュされています。 しかし残念ながら、まだパズルの一部が欠けています。引数a (翻訳されるテキスト)に加えて、別の引数bが関数Bp()に渡されます。これは時々変化するように見える一種のシードであり、これには次のものも含まれます。ハッシュに流れ込みます。 しかし、彼はどこから来たのですか? Bp()の関数呼び出しにジャンプすると、次のコードセクションが見つかります。:
b7739bf50b2edcf636c43a8f8910def9
関数Hqは、次のように事前に宣言されています。:
b7739bf50b2edcf636c43a8f8910def9
難読化解除者はここにゴミを残しました。 String.fromCharCode('...')をそれぞれの文字列に置き換え、廃止されたa()を削除し、関数呼び出し[c(), c()]を結合すると、次のようになります。:
b7739bf50b2edcf636c43a8f8910def9
またはさらに簡単:
b7739bf50b2edcf636c43a8f8910def9
関数yqは、以前は次のように定義されています。:
b7739bf50b2edcf636c43a8f8910def9
したがって、シードはグローバル オブジェクトgoogle.translate._const._ctkk内にあるようで、実行時に使用できます。しかし、それはどこに置かれているのでしょうか?少なくとも、以前にロードされた他の JS ファイルmain_de.jsの先頭でも利用できます。冒頭に以下を追加します:
b7739bf50b2edcf636c43a8f8910def9
コンソールでは、実際に現在のシードを取得します:

これにより、最後のオプションとして、明らかにシードを提供するGoogleChrome自体が残ります。 幸い、そのソースコード(Translateコンポーネントを含むChromium)はオープンソースであるため、公開されています。 リポジトリをローカルにプルし、 components / translate / core / browserフォルダーのtranslate_script.ccファイルでTranslateScript :: GetTranslateScriptURL関数の呼び出しを見つけます。:
b7739bf50b2edcf636c43a8f8910def9
URLを持つ変数は、同じファイルでハード定義されています:
b7739bf50b2edcf636c43a8f8910def9
element.jsファイルを(さらに難読化を解除した後)さらに詳しく調べると、ハード セット エントリc._ctkkが見つかります。これに応じてgoogle.translateオブジェクトも設定され、関連するすべてのアセット(以前に発見済み)の読み込みがトリガーされます。:
b7739bf50b2edcf636c43a8f8910def9
これで、パラメータキーは検討対象のままになります(値AIzaSyBOti4mM-6x9WDnZIjIeyEU21OpBXqWBgwを使用)。 これは一般的なブラウザAPIキーのようです(一部のGoogleの結果にもあります)。 これは、コンポーネント/ translate / core / browserフォルダーのtranslate_url_util.ccファイルのChromiumに設定されています。:
b7739bf50b2edcf636c43a8f8910def9
キーは、ダミー値からgoogle_apis /google_api_keys.ccに生成されます:
b7739bf50b2edcf636c43a8f8910def9
しかし、テストの結果、この重要なパラメータがなくてもAPI呼び出しは問題なく機能することが分かりました。APIをテストしたところ、呼び出しが成功した場合はステータスコード200が返されます。制限に達した場合は、ステータスコード411が返され、「 POSTリクエストにはContent-lengthヘッダーが必要です」というメッセージが表示されます。そのため、このヘッダー(Postmanでは一時ヘッダーとして自動的に設定されます)も含めることをお勧めします。
1つのリクエストに複数の文がある場合、翻訳された文字列の戻り形式は異常です。 個々の文はi- / b-HTMLタグで囲まれています:
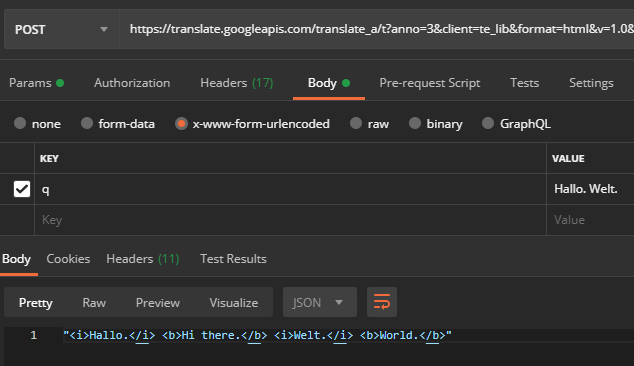
また、Google ChromeはHTML全体をAPIに送信しませんが、リクエストにhrefなどの属性値を保存します(代わりに、タグを後でクライアント側で割り当てることができるようにインデックスを設定します):
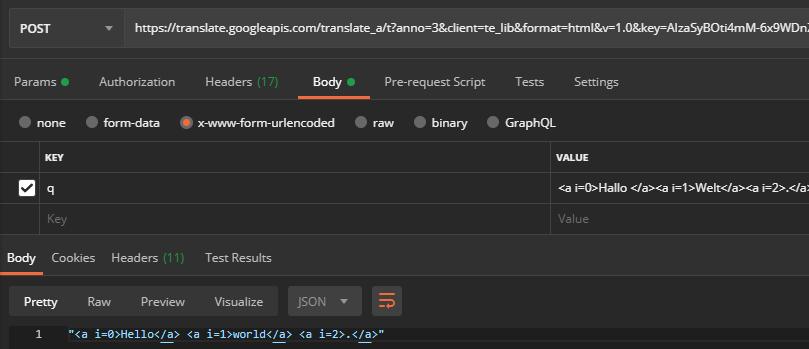
POSTキークライアントの値をte_lib (Google Chrome)から変更した場合 webapp ( Google Translation Webサイト)では、最終的な翻訳文字列を取得します:
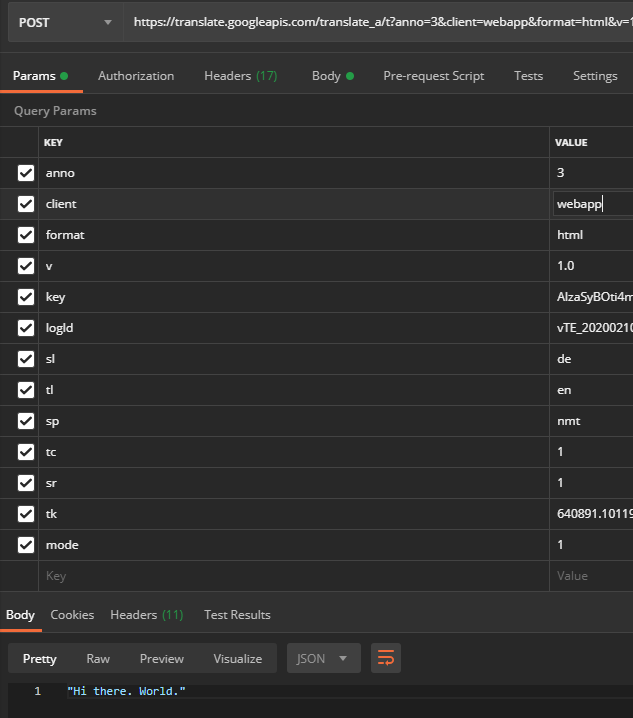
問題は、 te_libを使用するよりもレート制限に遭遇する可能性がはるかに高いことです(比較のために: webappでは40,000文字後に到達しますが、 te_libではレート制限はありません)。 したがって、Chromeが結果をどのように解析するかを詳しく調べる必要があります。 element_main.jsにあります:
b7739bf50b2edcf636c43a8f8910def9
HTMLコード全体をAPIに送信すると、変換された応答に属性が残ります。 したがって、解析動作全体を模倣する必要はありませんが、応答から最終的な変換された文字列を抽出するだけです。 これを行うために、コンテンツを含む最も外側の<i>タグを破棄し、最も外側の<b>タグを削除する小さなHTMLタグパーサーを構築します。 この知識があれば( composerで依存関係をインストールした後、fzaninotto / faker vielhuber / stringhelperが必要です)、サーバー側バージョンの翻訳APIを構築できます。:
b7739bf50b2edcf636c43a8f8910def9
以下は、帯域幅と IP アドレスが異なる 5 つの異なるシステムで実行された初期テストの結果です。:
| キャラクター | リクエストごとの文字 | 期間 | エラー率 | 公式APIによるコスト |
| 13.064.662 | ~250 | 03:36:17時間 | 0% | 237,78 € |
| 24.530.510 | ~250 | 11:09:13時間 | 0% | 446,46 € |
| 49.060.211 | ~250 | 20:39:10時間 | 0% | 892,90 € |
| 99.074.487 | ~1000 | 61:24:37時間 | 0% | 1803,16 € |
| 99.072.896 | ~1000 | 62:22:20時間 | 0% | 1803,13 € |
| Σ284.802.766 | 〜Ø550 | Σ159:11:37時間 | 0% | €5183.41 |
注:すべてのスクリプトを含むこのブログ投稿は、テスト目的でのみ作成されました。 スクリプトを生産的な使用に使用せず、代わりに公式のGoogle TranslationAPIを使用してください。